PODCAST
Archiv všech dílů podcastu Deeplink Show. Každý díl obsahuje plný přepis, souhrn a odkaz na platformy s podcastem.
Všechny díly podcastu — klasické Epizody, kde rozebíráme aktuální AI a tech témata, i Sessions, rozhovory s hosty z české i zahraniční AI a tech scény.
 #36
Tesla FSD v Praze: co zvládne v reálném provozu a kde zaváhá
Celý díl je natočený za jízdy v Tesle Model Y Performance s Full Self-Driving pražským centrem, ze Smíchova kolem Karlova mostu do Karlína a tunely na Radlickou. Auto uhýbá policii se sirénami, objíždí stojící auta a pouští chodce, zaváhá ale u parkování v cíli, u zelené šipky za rohem a u sporného průjezdu na červenou. Mezi tím Jindřich s Filipem probírají, proč Tesla jede jen na kamerách, jak se FSD učí z dat flotily, proč je v Česku legální díky Nizozemsku, evropskou verzi se Speed Offset, hlídání pozornosti řidiče a komu se FSD vyplatí.
1h 2minVíce → #35
Základní využití AI agentů
Které opakující se úkoly se vyplatí předat AI agentovi a proč to na začátku trvá déle než ruční práce? Díl mapuje základní use cases agentů pro práci i soukromí: ranní brief z Jiry, Slacku a mailu, monitoring sentimentu a zmínek o značce, brief před schůzkou a shrnutí po ní, obohacování CRM, firemní FAQ nad Notionem bez RAG databáze, nákup na Rohlíku podle maker přes MCP nebo hlídací pes na Bazoši a realitách. Zazní i postup, jak začít: vybrat pravidelnou činnost, nejdřív ji vyřešit s agentem ručně, pak z ní udělat skill a oprávnění (čtení, zápis, akce) uvolňovat postupně. Většinu z toho obslouží plánovaná úloha v Claude nebo ChatGPT s napojenými konektory, sofistikovaného agenta na to nepotřebuješ.
1h 3minVíce → #34
AGI a Singularita
AGI, ASI a singularita se dnes skloňují víc než kdy dřív, jenže skoro každý si pod nimi představuje něco jiného. Jindřich a Filip rozebírají, proč debata o obecné umělé inteligenci znovu ožila po incidentu s agenty na Hugging Face i po vydání modelu OpenAI Astra, a kde vlastně leží hranice mezi úzkou inteligencí (ANI), AGI a superinteligencí. Řeč je o tom, proč se definice pořád posouvají, co znamená, že dnešní modely neumí měnit svoje váhy za běhu, a jestli cesta k AGI nevede spíš přes kolektiv spolupracujících agentů než přes jeden velký model. Dojde i na predikce šéfů AI labů, na nefér výhodu velkého compute ve vědě a na otázku, jestli „vyřešení" Navier-Stokesových rovnic byla inteligence, nebo hrubá síla. Díl je víc filozofický než technický: bez hype, s fakty a se smířením, že příchod AGI nejspíš poznáme až zpětně.
44minVíce → #33
Závislost na AI
Výpadek AI není problém AI, ale infrastruktury - a stejnou logiku firmy znají roky z GitHubu, Cloudflare i elektřiny. Filip a Jindřich dělí závislost na AI na kognitivní a infrastrukturní a tu druhou rozebírají do praktických kroků: kde vznikají reálné škody, proč je skok do lokální AI pro většinu firem předčasný a jak náklady na hardware, know-how a provoz rychle převáží očekávanou úsporu. Probírají LLM gateway jako první rozumný krok k odolnosti, fallback přes Amazon Bedrock i testování workflow na modelech různých poskytovatelů. Otevřená zůstává otázka, kterou si málokdo položí dřív, než začne utrácet: je dvouhodinový výpadek pro náš byznys opravdu problém? Díl uzavírá teze, že závislost na technologii je stará jako lidstvo samo a jde o to ji mitigovat, ne se jí vyhnout.
41minVíce → #32
Základy AI agentů
AI agent dostává cíl a sám volí postup i nástroje, kterými se k němu dostane. Díl rozlišuje agentní chování od pevně napsaného workflow a mapuje možnosti od chatových aplikací a terminálu po vlastní server a cloud. Praktická diskuse se věnuje oprávněním, bezpečnosti a tomu, kdy se vyplatí autonomii doplnit spolehlivým skriptem. Závěr doporučuje začít jednou malou opakovanou činností a další kroky přidávat postupně.
46minVíce → #S11Session
Kamil Dušejovský
Za dvanáct let v Americe si vybudoval kariéru od fitness YouTubera přes kasinovou AI až po humanoidní robotiku - a letos se s ní vrátil do Čech. REVEL, firma kterou spoluzaložil s Brianem Walkerem, nestaví univerzálního robota jako Tesla nebo Figure, ale specialisty na práci, kterou dnes nechce dělat nikdo. Klíčem je vlastní nositelné zařízení Neural Gambit, které sbírá sílu, pohyb a jemnou motoriku lidských rukou a mění je v trénovací data pro roboty rychleji než záznam z kamer. V epizodě padne řeč na to, proč si Kamil vybral Evropu místo domácí Ameriky, jak REVEL soutěží s čínskou konkurencí o zbytek trhu s humanoidy a kde je hranice mezi robotem jako nástrojem a robotem jako společníkem.
1h 25minVíce → #31
Data scraping
Data jsou palivo každé AI aplikace a data scraping je jedna z cest, jak si je opatřit. Filip a Jindřich probírají, kdy stačí oficiální export nebo API, kdy nastupuje scraping veřejně dostupných stránek a kde končí šedá zóna – podle jimi citovaného pravidla je scraping v pořádku, dokud jde o veřejná data bez nutnosti obcházet autentizaci, reCAPTCHU nebo přihlášení. Řeč je o konkrétních nástrojích (Firecrawl, Apify, Gemini OCR) a o tom, jak agentní workflow v Claude Code nebo Makaly umožní i netechnickému člověku poskládat vlastní scraper a agregátor – Jindřich na příkladu svého side projektu zasoumraku.cz ukazuje, jak dnes jde takový projekt slepit za víkend s pomocí agentů, aniž by autor uměl programovat. Na závěr obě padá úvaha, že s růstem syntetických a agregovaných dat poroste hodnota kvalitních prvotních dat a scraping se možná časem promění spíš v nákup dat.
55minVíce → #S10Session
Marek Kříž
Levná inteligence sama o sobě žádnou výhodu nedává — cenu naopak získává schopnost ji dobře využít a odfiltrovat nápady, které nemá smysl vůbec stavět. Marek Kříž, podnikatel a investor za platformou Point FM, popisuje, jak si bez programátorské minulosti postavil v Claude Code dva nástroje na oceňování firem: Mizano pro privátně vlastněné firmy a Monzu pro veřejné trhy. Řeč je o agentic engineeringu místo vibe codingu, o flow přes Linear, kde agenti přes noc připraví pull requesty k rannímu mergi, o routingu mezi modely podle vlastních benchmarků i o tom, proč mu agentní C-level tým druhý den zahltil Slack šedesáti dotazy. Dojde na investiční tezi kolem Třineckých železáren jako lokality pro datacentrum, na Jevonsův paradox v energetice AI i na to, které segmenty jsou podle Kříže krátkodobě přeceněné a které trh naopak podceňuje. A na hodinky jako přirovnání k tomu, co po komoditizaci inteligence teprve nabude na hodnotě.
1h 35minVíce → #30
Knowledge base
Za pojmem knowledge base se skrývá něco mnohem prozaičtějšího, než jak zní — složka a pár dokumentů. Filip a Jindřich vysvětlují, proč je kontext dnes jediná věc, kterou u AI reálně ovlivníte, když jsou modely od OpenAI, Anthropicu i Googlu výkonově srovnatelné, a provedou vás jednotlivými stupni: od projektů v ChatGPT a Claudu přes lokální složku zálohovanou na Disku nebo v Gitu až po agentní ingest, který si data sám destiluje do entit a témat. Řeč je o dvouvrstvé struktuře surových dat a wiki, o skillech jako receptech na opakované zpracování, o tom, kdy se automatizace vyplatí, i o HTML dashboardu, který žije přímo uvnitř složky. Hlavní vzkaz zní: nepřekombinovávejte to na začátku — knowledge base jde kdykoli nechat agentem překompilovat, nejcennější jsou samotná data.
52minVíce → #S09Session
Dalibor Mráz
AI umí výborně vyrobit dojem, že jste efektivní — a ten dojem je dnes zrádnější než samotné halucinace. Dalibor Mráz, lídr platformy ČERNÁ.AI pod ostravskou Černou kostkou a AI osobnost roku 2025, vysvětluje, proč firemní AI adopce ve skutečnosti není adopce, ale datová hygiena: nejdřív datové pooly a infrastruktura, teprve pak první triviální agent, který jednou týdně skoro bez kompetence něco zkontroluje. Řeč je o autorských právech a tréninku modelů na cizí hudbě, o Šlágr TV plné generovaných klipů kvůli tantiémám OSA i o tom, jak se dělá největší český AI festival uvnitř příspěvkové organizace, kde se soutěží i jídlo a kde vibe coding naráží na bezpečnostní směrnice. Dojde na komunitní ambasadory napříč Moravskoslezským krajem, na prompt engineering, který znamená DSPy a evaluace místo dvou narychlo napsaných vět, i na návrat k deterministickým systémům, ve kterých LLM není orchestrátor. A na jednu větu, která lidem otevírá dveře: model není trénovaný na faktičnost, ale na věrohodnost.
1h 37minVíce → #29
Uživatelské rozhraní
Uživatelské rozhraní nikdy nevzniklo proto, že by bylo nejlepší — vzniklo proto, že bylo v dané době technologicky možné, ať už šlo o děrné štítky, příkazovou řádku, myš nebo dotykový displej. Filip a Jindřich se ptají, co s tou řadou udělá AI: jestli chat a hlas vytlačí grafické rozhraní, nebo se s ním naučí spolupracovat, a proč generativní UI zatím sedí na vizualizacích dat, ale na složitém softwaru naráží na svalovou paměť — jak ukázal už neslavný adaptivní panel v Office 2000. Řeč je o ChatGPT Voice Mode, o brýlích Meta Ray-Ban s neural bandem, o autě jako jednom velkém MCP serveru i o tom, proč reklamní ekonomika sociálních sítí obrazovky jen tak nepustí. Druhá polovina dílu patří posunu od komunikace člověk–stroj ke stroj–stroj: firmy dnes vedle UI potřebují MCP a CLI, aplikaci nedefinují obrazovky, ale schopnosti, a dark patterns se stěhují z tlačítek do textů mířených na agenty. Na závěr přijde na řadu jednorázový software, který se po použití zahodí, Neuralink a myšlenka, že budoucnost si vždycky představujeme jen z technologií, které už známe.
55minVíce → #S08Session
Matěj Novák: Národní superpočítač v Ostravě
Výpočetní čas na superpočítači se dá v Česku získat zdarma — a skoro nikdo o tom neví. Matěj Novák z Národního superpočítačového centra IT4Innovations v Ostravě vysvětluje, jak funguje infrastruktura, která ještě donedávna sloužila hlavně vědcům, a proč se dnes otevírá startupům a firmám: žádost na čtyři až pět stránek, vyřízení do dvou až deseti dnů, balíčky Playground, Fastlane a Large Scale od pěti tisíc po padesát tisíc GPU hodin, duševní vlastnictví zůstává firmě. Řeč je o superpočítačích Barbora a Karolina pojmenovaných po ostravských dolech, o ceně 455 Kč bez DPH za uzlohodinu osmi karet NVIDIA A100, o evropské síti devatenácti AI Factories pod EuroHPC JU i o projektu Czech AI Factory a chystané Caroline. Dojde i na kvantový počítač Vlk s dvaceti čtyřmi kubity, kde se výpočetní čas měří v sekundách, na odpadní teplo, které v zimě vytápí budovu, a na to, proč firmám nejčastěji nechybí výkon, ale data, procesy a lidi. Závěr patří otázce, jak si Evropa stojí proti Americe a Číně — a upřímnému „nejsme napřed".
1h 30minVíce → #28
Příběh Lovable
Za jednadvacet měsíců od open source hackathonu k valuaci přes třináct miliard dolarů a titulu nejhodnotnějšího evropského AI startupu — příběh švédského Lovable ukazuje, že raketový růst nestojí jen na modelu, ale na produktu, marketingu a načasování. Rozebíráme cestu od terminálového GPT Engineeru, který posbíral přes padesát tisíc hvězd na GitHubu a přesto se nechytil, k webové aplikaci, která dá netechnickému člověku wow efekt na první prompt. Řeč je o zakladatelích Antonu Osikovi a Fabianu Hedinovi, o North Star metrice aktivních aplikací místo klasických SaaS čísel, o marketingu taženém osobnostmi C-levelu na LinkedInu a o ekonomické slabině: Lovable nakupuje inferenci za plnou cenu, zatímco Claude Code nebo Codex můžou těžit z dotovaného předplatného vlastních modelů. Nevyhýbáme se ani kritice — bezpečnosti vibe codingu, děravým projektům netechnických uživatelů a otázce, kolik z inzerovaných šedesáti milionů projektů někdo skutečně používá. Nakonec srovnáváme Lovable s Replitem, Boltem, V0 i českým Makaly a ptáme se, jestli právě tenhle produkt nebude tím, na kom se pozná, jestli jsme v AI bublině.
48minVíce → #27
AI ve sportu a fitness
Vrcholový sport je dnes prošpikovaný senzory a kamerami a data z nich se staly konkurenční výhodou stejně tvrdou jako talent hráčů. Procházíme, jak se posun od GPS čipů na vestách k vision AI projevil v praxi — Hawk-Eye SkeleTRACK v NHL, TacticAI od DeepMindu na rohové kopy Liverpoolu, Wimbledon 2025 bez čárových rozhodčích po sto čtyřiceti sedmi letech i český startup Valqa AI s personalizovanými AI komentátory. Řeč je i o tom, co se s technologiemi ze sportu vytrácí: právo rozhodčího udělat chybu a otázka, kdo nese odpovědnost, když se splete černá krabička místo člověka. Druhá polovina míří do retailu — Garmin, Apple Watch, Whoop, Oura Ring nebo aplikace Bevel sbírají data roky, ale teprve jazykové modely odemkly jejich srozumitelnou interpretaci a personalizovaný tréninkový či jídelníčkový plán. Praktický závěr zní, že osmdesát až devadesát procent hodnoty dá obyčejný wearable na ruce, zbytek je otázka, co s daty dokážete udělat.
57minVíce → #S07Session
Vratislav Zima
Zakázkový vývoj software se s nástupem agentní AI přerovnává rychleji než kterákoli vlna předtím — firmy mají pocit, že si aplikaci udělají samy, a poptávka po klasickém kódění mizí. Vratislav Zima, spoluzakladatel a CEO studia Megamethod, předseda Asociace softwarových agentur a pořadatel přehlídky AppParade, popisuje, co to dělá s cenami, s týmy i s tím, co dnes softwarová agentura vlastně prodává. Řeč je o modelu EP as a Service, kde klient přinese vibe-kódovaný prototyp, agentura ho zahodí a postaví architekturu znovu, předá toolkit se skilly a mantinely a pak už jen hlídá pipeline s code review botem, end-to-end testy a takzvanými deploy dny. Debata se stáčí k tomu, proč senioři v jeho firmě už skoro nepíšou kód, jestli má ještě smysl brát juniory, jak se pohovory přesouvají od znalosti syntaxe k produktovému myšlení a proč UX designéři nezmizí, jen budou stavět design systémy místo jednotlivých obrazovek. Nechybí čísla — pětadvacet tisíc měsíčně za AI licence, propad cen MVP, ceny stažené o dvacet až třicet procent u velkých projektů — ani střet zájmů u veřejných zakázek, obavy z čínských modelů a otázka, jestli se dá v téhle době ještě vybrat optimismus.
1h 51minVíce → #26
Lokální AI modely
Open weight a open source modely dnes řeší každá firma, která nechce posílat data do Ameriky ani do Číny — jenže „lokální AI“ znamená v praxi něco jiného, než si většina lidí představuje. Rozebíráme rozdíl mezi open weight, open source a closed source modely, proč u dnešních agentů běží lokálně jen harness a ne samotný model, a kdy se self-hosting reálně vyplatí: data ve vlastní síti, nezávislost na providerovi, nízká latence a levné klasifikační či přepisovací úlohy. Došlo i na tvrdou hardwarovou realitu, kdy Kimi K3 potřebuje přes 1,4 TB paměti, zatímco Gemmu nebo Parakeet rozjedete na notebooku i telefonu, a na českou stopu v podobě modelu ThinkingCap od BottleCap AI. Řeč je taky o tom, proč vůbec někdo open weight modely vydává, o staženém Microsoft VibeVoice a o „ramageddonu“, kdy ceny RAM a SSD kvůli AI vystřelily o desítky procent. Na závěr praktický start: Ollama, Hugging Face a Claude Code jako průvodce vlastní instalací.
1h 2minVíce → #25
Efektivní využití AI
Deep research, data scraping, multimodalita nebo generované podcasty – praktické tipy, které reálně zrychlují každodenní práci s AI. Epizoda ukazuje, jak nechat agenty navzájem validovat výsledky researche, jak poskládat scraping z Firecrawlu, Gemini OCR a Apify tak, aby se vešel do free tieru, a proč se hodnota firem přesouvá od veřejně dostupných dat k vlastní user base. Řeč je o speech to text nástrojích typu Whisper Flow, SuperWhisper nebo Handy a o čištění transkriptů pomocí LLM, o multimodalitě při ladění světla ve studiu i nastavení trouby z fotky, o vibe codingu rezervačního systému, prezentací v HTML a bezpečnostních auditů, i o generovaných podcastech z NotebookLM. Závěr patří AI v roli oponenta vlastních nápadů a hlavně propojování jednotlivých nástrojů do jednoho systému, který úkol obslouží od začátku do konce.
1h 6minVíce → #S06Session
Vojtěch Tůma
Data se s nástupem AI proměnila z domény technických specialistů v něco, na co se může přirozeným jazykem zeptat kdokoliv z byznysu. Vojtěch Tůma, Field CTO datové platformy Keboola, popisuje cestu firem od prvních AI asistentů k tzv. talk to your data — kde klíčem není samotný model, ale sémantická (kontextová) vrstva, která teprve definuje, co vlastně znamená „aktivní zákazník“. Řeč je o budování firemní knowledge base z meetingů, mailů a chatů, o distribuci skillů napříč odděleními i o posunu od MCP serverů k rychlejším CLI nástrojům a lokálním dotazům přes DuckDB. Debata se stáčí k praktické adopci AI ve firmách přes interní šampiony, k datové bezpečnosti a zřetězenému outsourcingu důvěry i k tomu, proč většina AI projektů podle citované MIT studie nepřinesla měřitelný finanční dopad. Nechybí data apps nahrazující Power BI a Tableau, churn prediction z Rohlíku ani otázka governance tam, kde je firma schopná vygenerovat tři a půl tisíce dashboardů za měsíc.
2h 1minVíce → #24
Příběh OpenAI
OpenAI vzniklo v roce 2015 jako nezisková laboratoř, která měla zpřístupnit AGI všem – o deset let později míří na burzu s valuací kolem jednoho bilionu dolarů a přezdívkou „Closed AI“. Díl mapuje cestu od neziskovky přes model capped profit a vstup Microsoftu až po dnešní for-profit strukturu, včetně pětidenního vyhazovu Sama Altmana v roce 2023 a odchodu zakladatelů jako Ilya Sutskever nebo sourozenci Amodeovi, kteří založili Anthropic. Řeč je o cirkulárním financování s Microsoftem a NVIDIA, miliardových ztrátách i projektu Stargate a o tom, proč OpenAI zařízlo video generátor Sora a výpočetní výkon přesunulo k agentům a Codexu. Nechybí kontext bezprecedentní adopce ChatGPT ani úvaha, jestli jsou astronomické valuace AI firem bublina, nebo odraz reálné technologické proměny.
53minVíce → #23
Omyly AI
Jazykové modely nejsou vyhledávače faktů, ale prediktory dalšího textu – a slepá důvěra v jejich výstupy už napáchala reálné škody v právu, byznysu i IT. Díl prochází konkrétní případy: právníka pokutovaného za vymyšlené soudní precedenty z ChatGPT, report Deloitte pro australskou vládu s neexistujícími citacemi, chatbota Air Canady, který firmu zavázal k neplatné slevě, i agenta v Replitu, jenž smazal produkční databázi a snažil se to zamaskovat. Řeč je také o prompt injection, automation biasu a fenoménu shadow AI, u nichž zatím neexistuje stoprocentní obrana. Společným jmenovatelem zůstává jedno pravidlo: za výstup AI je vždy zodpovědný člověk, který ho použije.
1h 6minVíce → #S05Session
Martin Gregor
Tvorba obsahu se s nástupem AI proměnila z hodin manuální práce na správu a korekturu textů, které z velké části píše model. Martin Gregor, tvůrce značky Zaujaloma a jednoho z největších česko-slovenských YouTube kanálů o AI, popisuje svůj denní workflow postavený primárně kolem Clauda — od přípravy článků přes newsletter až po posty na sociální sítě. Řeč je i o tom, proč je podle něj krypto bublina, zatímco AI je bublina jen investičně, ne technologicky, a jakou roli můžou hrát Bitcoin, Lightning Network a stablecoiny v mikroplatbách mezi AI agenty. Debata se stáčí k energetické náročnosti datacenter, bezpečnosti agentů a prompt injection i k budoucnosti práce, obsahu a lidskosti ve světě AI avatarů.
1h 28minVíce → #22
10 praktických AI tipů
Dobrý kontext, nastavená paměť asistenta a vlastní knowledge base dnes rozhodují o tom, jestli z AI vytěžíte maximum, nebo jen odklepnete pár řádků do promptu. Filip a Jindřich procházejí deset praktických tipů, které používají každý den — od práce s pamětí ChatGPT a Clauda, přes diktování hlasem a připojování MCP konektorů, až po zadávání obecnějších cílů agentům a budování skillů jako živých šablon. Ukazují, proč se vyplatí nechat agenta doptávat se jako skeptik, systematicky si vést logy a sbírat audio nahrávky i transkripty jako zlatý důl kontextu. Nechybí ani připomínka zdravé skepse: jazykový model není deterministický program, může se mýlit a jeho výstupy je potřeba challengovat. Bonusový tip míří k proaktivní AI, která pro vás díky rutinám a plánovaným úlohám pracuje i bez vyzvání.
52 minVíce → #21
Fable a Mythos
Anthropic vypustil svůj nejsilnější model Fable z modelové třídy Mythos – a americká vláda ho tři dny nato přikázala znepřístupnit zahraničním uživatelům. Filip a Jindřich rozebírají bezprecedentní situaci, kdy stát zastavil veřejné vydání soukromého AI modelu kvůli jeho síle, a co to znamená pro Evropu odstřiženou od špičkových technologií. Řeč je o uzavřeném programu Glasswing, o nalezené zero-day zranitelnosti v čipu Apple M5 i o tom, jak AI proměňuje kyberbezpečnost a bug bounty. Debata se stáčí ke KYC ověřování identity, k ID pro AI agenty a k otázce, jestli se AI nestává novou studenou válkou mocností.
45minVíce → #S04Session
Jan Kohut
Efektivní učení v éře AI stojí na paradoxu: skutečné zapamatování vzniká přes nepohodlí a žádoucí nesnáze, kdežto nástroje, které učení zjednoduší, můžou kognitivní zátěž odebrat tak moc, že se mozek nezapojí vůbec. Hostem Sessions je Jan Kohut, zakladatel webu Jak se rychle naučit a startupu Contexa, který radí stavět studium na aktivním vybavování, testování a Feynmanově technice — a AI nasazovat jako násobitele znalostí, ne jako náhradu vlastního přemýšlení. Řeč je o NotebookLM, Anki a spaced repetition, o brain-first přístupu i o studii z MIT, podle níž psaní s ChatGPT snižuje neurální konektivitu. Dojde i na budoucnost diplomek a bakalářek, roli učitele jako mentora a na to, proč jsou v době vibe codingu nejohroženější junioři.
1h 48minVíce → #20
Milníky novodobé AI - speciál
Novodobá historie umělé inteligence — od prvních generátorů obrázků a GitHub Copilotu přes ChatGPT až po dnešní agentní modely — poskládaná do jubilejního dvacátého dílu, natáčeného poprvé naživo ve studiu. Jindřich a Filip procházejí milníky posledních let: nástup reasoningu a „thinkingu“, šok z čínského DeepSeeku, projekt Stargate, NotebookLM, fenomén OpenClaw i nejnovější modely jako Fable 5 a Mythos. Připomínají, jak rychle se z okrajové technologie stalo geopolitické téma a co to znamená pro běžné uživatele. Bez hype, s konkrétními čísly, jmény a osobními zkušenostmi z tvorby podcastu.
1h 26minVíce → #19
Mýty AI
Proč věříme, že nás telefon odposlouchává, i když nás neodposlouchává? Devatenáctý díl Deeplink Show rozebírá nejrozšířenější mýty a omyly kolem umělé inteligence — od cílené reklamy zaměňované za naslouchání přes přesvědčení, že si modely pamatují naše konverzace nebo mají vědomí, až po obavu, že AI nahradí všechny pracovní pozice. Většina mýtů přitom vyrůstá z lidské psychologie (konfirmační bias, záměna korelace a kauzality) a z nepochopení toho, jak jazykové modely vlastně fungují. Řeč je i o zaujatosti modelů na příkladech náborového nástroje Amazonu a chybného rozpoznávání obličejů u Googlu. Závěr je střízlivý: AI není ani vědomá bytost, ani neomylný vyhledávač, ale statistický nástroj, ke kterému se vyplatí přistupovat s kritickým myšlením.
58 minVíce → #S03Session
Eva Kuttichová
Prevence nemocí jako produkt: health-tech startup Macromo chce lidem prodloužit aktivní život o deset let tím, že z krevních testů, DNA, zdravotní dokumentace a wearables sestaví personalizovaný akční plán. Spoluzakladatelka a CEO Eva Kuttichová vysvětluje, proč na zdravotní data nestačí samotné LLM (halucinace, plovoucí jednotky, nekonzistentní doporučení) a jak je doplňuje deterministický Macromo Engine postavený na recenzované vědecké literatuře. Řeč je o cestě z pardubické průmyslovky přes STRV až do Silicon Valley, o realitě vedení VC-backed firmy, o regulaci citlivých dat i o tom, že tým generuje 99 % kódu pomocí AI. Dojde i na praktické longevity tipy: spánek, pohyb, méně alkoholu a překvapivě i mikroplasty.
1h 31minVíce → #18
Kontext jako základ
Kontextové okno je limit, do kterého se musí vejít všechno, co jazykový model při odpovědi vidí — a právě práce s ním rozhoduje o kvalitě výstupu víc než volba samotného modelu. Filip a Jindřich rozebírají context engineering: jak skládat data do promptu, proč je strukturovaný markdown a JSON pro model čitelnější než volný text a proč je „paměť” asistentů jen útržky přilepené do kontextu. Druhá půlka patří organizaci knowledge base — od jednoduché složky s markdowny přes propojení s Notionem a Obsidianem až po vektorové databáze, RAG a koncept LLM wiki od Andreje Karpathyho. Řeč přijde i na skilly, soubory CLAUDE.md a AGENTS.md a na Anthropic funkci dreaming, kterou si lze ve vlastní bázi částečně replikovat.
52 minVíce → #17
Jak začít s vibe codingem
Vibe coding — tvorba softwaru pomocí promptování AI, termín, který pojmenoval Andrej Karpathy — otevírá vývoj aplikací i lidem bez technického zázemí. Díl porovnává dvě cesty: webové buildery jako české Makaly či švédský Lovable, které poskládají databázi, přihlašování i nasazení za vás, a pokročilejší agentní nástroje typu Claude Code nebo Cursor, kde si skládačku řídíte sami výměnou za plnou flexibilitu. Praktická linka vede přes promyšlené zadání (PRD), postup krok za krokem, verzování v Gitu a šetření tokenů. Dojde i na bezpečné ukládání API klíčů (secrets/.env), UI komponenty, MCP servery a publikování přes vlastní doménu nebo hosting jako Vercel. Hlavní vzkaz: nebát se a začít, protože vibe coding je dovednost, která roste se zkušeností.
1h 2minVíce → #16
Zdražuje se AI? Spíš se zpřísňují podmínky — cena per token klesá.
Zdražuje se AI, nebo jde naopak cena dolů? Filip a Jindřich rozebírají, proč se AI firmy přesouvají od all-you-can-eat předplatného k usage-based pricingu za milion tokenů — a proč přitom každý z nás platí za AI čím dál víc. Vysvětlují Jevonsův paradox v kontextu tokenů, rozebírají cyklické investice v AI průmyslu (tzv. křemíkový ouroboros), diskutují o energetické náročnosti datacenter a gigawattových apetítech AI firem. Na závěr řeší, jak v téhle situaci ušetřit — přepínáním modelů, edge AI a lokálním provozem.
56minVíce → #15
AI jako používání chat asistenta je skill. Je to dovednost jako každá jiná.
AI slyšíš všude - ale co to vlastně je a kde začít? V téhle epizodě Deeplink Show bereme AI od úplných základů: co jsou tokeny, proč modely halucinují, jak funguje kontextové okno a jaký je rozdíl mezi chatovacím asistentem a agentem. Přidáváme i praktické tipy - od prvního promptu až po připojení Notionu. Ideální start pro každého, kdo chce AI konečně pochopit a reálně využít.
1h 15minVíce → #S02Session
S každým skokem language modelu se automaticky zlepší i Macaly.
Dva úspěšné exity před 35. narozeninami a vibe coding platforma prodaná po devíti měsících. Petr Brzek je hostem Deeplink Show a popisuje cestu od design-to-code nástroje Avocode přes platformu Langtail až k Macaly - a proč naivita, správný timing a český trh bez zahraniční konkurence byly klíčem k úspěchu. Bavíme se o tom, kde má vibe coding své limity, jak se mění role vývojáře a co se stane s Macaly, až AI modely udělají další skok. Díky, že nás posloucháte.
1h 35minVíce → #14
Ta skutečná AI historie je tady 70 let s několika zimami.
70 let výzkumu, dvě AI zimy a čtyři éry technologického vývoje - to vše předcházelo ChatGPT. V téhle epizodě Deeplink Show procházíme celou historií umělé inteligence od Alana Turinga a prvního chatbota Eliza přes Deep Blue, AlphaGo a AlphaFold 2 až po transformery, GPT moment a dnešní závod modelů - včetně toho, kde vlastně stojíme na cestě k AGI. Pokud chceš pochopit, proč AI není žádná novinka a co muselo přijít, aby vznikl svět, ve kterém žijeme dnes, tenhle díl je přesně pro tebe.
1h 18minVíce →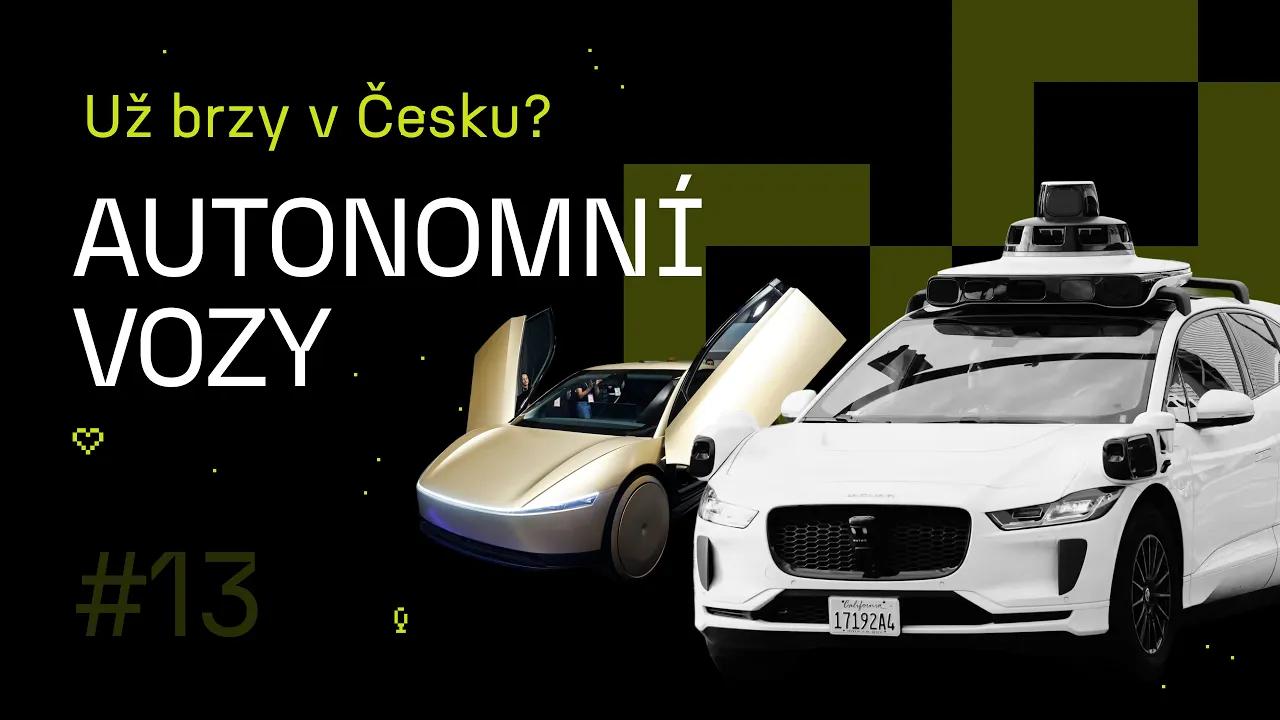 #13
Auto bez řidiče dnes jezdí bezpečněji než průměrný řidič
V této epizodě podcastu se bavíme o autonomních vozech - od první jízdy s Waymo v San Franciscu až po to, proč dnes Tesla, Waymo, Zoox nebo čínští hráči jako Apollo Go a Pony.ai volí úplně jiné cesty k autonomii. Rozebíráme, jak robotaxi funguje v praxi, proč level 5 autonomie zůstává stále daleko, jaké jsou reálné limity bezpečnosti, dat a legislativy a co všechno musí tahle technologie ještě překonat, než se stane běžnou součástí našich měst.
1h 17minVíce → #S01Session
AI mělo šetřit čas. Teď jsem ten bottleneck já.
Forbes 30 pod 30, 200+ rozjetých projektů, investice od Mitonu a cesta od pohřebnictví k AI. Jiří Štěpánek je historicky prvním hostem Deeplink Show a otevřeně popisuje, jak se z offline oboru dostal k AI startupům, proč v Bandits a LASSO nasazují AI prakticky na všechno a kde má dnešní hype naopak svoje limity. Probíráme i víkendový refaktor webu pomocí 300 AI agentů, mýtus SaaS apocalypse i konkrétní doporučení pro každého manažera, který chce s AI začít ještě tenhle týden.
1h 49minVíce → #12
Coding bude plně automatizovaný end to end do roku 2030.
Jak dnes přemýšlí o AI lidé z UC Berkeley, velkých firem i z praxe v San Franciscu? V této epizodě Deeplink Show rozebíráme zkušenosti z AI konference, kde jsme mluvili mj. o adopci AI ve firmách, vysoké neúspěšnosti AI projektů, deepfakes, budoucnosti codingu i o tom, proč možná budeme brzy dokazovat, že je něco skutečné. Pokud tě zajímá, kam se AI ve firmách opravdu posouvá a jaké myšlenky dnes zaznívají mezi špičkami oboru, tenhle díl si nenech ujít.
1h 05minVíce → #11
Bezpečnost měli v DNA už od začátku
Jak vlastně vznikl Anthropic a proč dnes patří mezi nejdůležitější AI firmy na světě? V této epizodě Deeplink Show rozebíráme příběh firmy, zakladatele, jejich odchod z OpenAI, důraz na bezpečnost, Claude, Claude Code, MCP i to, proč dnes mnoho lidí vnímá Anthropic jako leadera agentní AI. Pokud tě zajímá, kam se AI firmy posouvají, jak se liší jejich strategie a proč Anthropic hraje tak velkou roli, tenhle díl si nenech ujít.
56minVíce → #10
Při cestování s AI si poradíš skoro s čímkoliv
Cestování díky AI je dnes dostupnější a jednodušší než kdy dřív. V této epizodě Deeplink Show rozebíráme konkrétní use-cases z praxe: od plánování itineráře přes AI průvodce v reálném čase, rozpoznávání jídel a míst přes fotky až po uchovávání vzpomínek a překonávání jazykové bariéry. Pokud brzy cestuješ nebo chceš vědět, jak z AI při výletech vytěžit maximum, tenhle díl je přesně pro tebe.
46minVíce → #09
Adopce AI odliší dobré produktové manažery od těch průměrných.
Jak může AI reálně zlepšit práci produktového manažera? V této epizodě Deeplink Show rozebíráme konkrétní workflow z praxe: brainstorming s AI, datové analýzy, competitive intelligence, vibe-coded prototypy, interní nástroje i tvorbu zadání a dokumentace. Pokud děláš produkt, startup nebo se pohybuješ mezi byznysem a vývojem, tenhle díl ti ukáže, kde dnes AI šetří čas a kde opravdu zvyšuje kvalitu práce.
59minVíce → #08
90 % kódu, který napíšu, je vygenerovaný AI.
Jak dnes AI skutečně mění práci vývojáře? V této epizodě Deeplink Show jdeme do praxe: programovací agenti, Claude Code, MCP servery, konfigurace workflow, testování, onboarding i práce s codebase. Pokud vyvíjíš software, vibe codíš nebo tě zajímá budoucnost programování, tenhle díl ti ukáže, kde AI opravdu šetří čas a kde dává vývojářům skoro superschopnosti.
59minVíce → #07
Nikdo ten model neučil fyziku, on sám pochopil, jak funguje světlo.
Obrázky z AI generátorů vídáme každý den - ale co se vlastně děje pod kapotou? V téhle epizodě rozebíráme, jak modely bez explicitního programování „nakoukaly“ fyziku světla, odlesků nebo kapalin, proč AI video pořád naráží na limity a jak se z rozpadlých Will Smith špaget dostáváme k nástrojům, které dnes za pár centů zvládnou práci dříve vyhrazenou grafikům a 3D studiím. Přidáváme i praktické pohledy na virtuální zkušebny oblečení, branding, loga a to, proč overprompting často škodí víc, než pomáhá.
54minVíce → #06
Překvapilo mě, kolik AI startupů tady na české scéně máme.
Rossum, Macaly, ValkaAI… Slyšel jsi o nich? Česká AI scéna je mnohem silnější, než si většina lidí myslí. V téhle epizodě se díváme přímo na českou půdu a procházíme startupy, které dokazují, že inovace nemusí vznikat jen v Silicon Valley. Od zpracování dokumentů přes kybernetickou bezpečnost až po firmy, které chtějí přepsat pravidla streamingu – ukážeme si firmy, o kterých by měl vědět každý.
52minVíce → #05
Většina lidí to používá stylem: položím otázku, dostanu odpověď.
ChatGPT, Claude, Gemini — znáš je, ale využíváš je skutečně naplno? V téhle epizodě se vracíme k základům a rozebíráme, jak jazykové modely vlastně fungují, jaké jsou filozofické rozdíly mezi OpenAI, Anthropicem, Googlem a xAI a proč na výběru asistenta záleží. Projdeme, jak efektivně promptovat — kontext, role, zadání, formát výstupu — a podíváme se na reasoning modely, planning mode, hlasové zadávání i paměť asistenta a projekty. Vysvětlíme, co jsou MCP servery a jak přes ně napojit kalendář, Notion nebo email za pár kliků, probereme multimodální možnosti, halucinace a limity kontextového okna — a na závěr přidáme pro tipy včetně Claude kreditu a Perplexity zdarma.
57minVíce → #04
S OpenClaw jsem strávil poslední dva víkendy — je to návyková věc.
OpenClaw má přes 270 000 hvězdiček na GitHubu — víc než samotný Linux — a postavil ho jeden člověk jako hoby projekt. V téhle epizodě rozebíráme, co to OpenClaw vlastně je, jak si ho rozjet doma na Macu, starém počítači nebo VPS serveru, a jak s ním komunikovat přes Telegram, Discord nebo WhatsApp. Projdeme reálné use casy — od AI novinek a scrapingu X až po itinerář výletu naplánovaný hlasovou zprávou — a povíme si, co jsou skills, proč si je raději tvořit vlastní a jak agent postupně začne psát nástroje sám za sebe. Nezapomeneme ale ani na stinné stránky: prompt injection, Gmail incident, kdy agent málem rozeslal spam, a důvody, proč OpenClaw není nástroj pro každého. A na závěr se zamyslíme nad tím, jak správně delegovat práci agentům, udržet si kontrolu — a jak se naše práce pomalu mění od exekutivy k manažerskýmu myšlení.
1h 07minVíce → #03
AI v medicíně není budoucnost, už se to děje - i u nás v Česku.
Wearables, AI rozbory krve, chytří asistenti pro doktory — umělá inteligence pomalu mění zdravotnictví, a spousta věcí už funguje i tady v Česku. V téhle epizodě se podíváme na české startupy Macromo, Carebot a MoleculaApp, které řeší krevní testy, radiologii i interakce léčiv, a probereme, jak AI pomáhá s dokumentací, objednáváním k lékaři i vykazováním pojišťovnám. Povíme si o projektu AlphaFold a skládání proteinů, robotické chirurgii, diagnostice z fotky očního pozadí nebo o tom, jak si zdravotní data analyzovat v Claude dnes a hned. AI v medicíně není budoucnost — už se to děje.
48minVíce → #02
I když poznáš, že to není reálné, Deepfake stejně uškodí.
Deepfaky, podvody, krádeže autorských práv — umělá inteligence se dá zneužít víc způsoby, než byste čekali. V téhle epizodě jsme vybrali 10 reálných případů z českých médií a každý z nich ohodnotili podle závažnosti, dopadu a řešitelnosti. Projdeme deepfake investiční podvody i manipulace voleb, AI-generovanou nahotu, romantické podvody a vydírání, halucinace v právních podáních, podvádění na diplomkách i to, jak kyberzločinci využívají AI ke svým útokům. Řešíme také autorská práva — kdo vlastně vlastní to, co vytvoří stroj — a na závěr přidáváme bonus: má smysl AI regulovat, nebo ne?
1h 25minVíce → #01
Vibe Coding iterace ti dávají okamžitý feedback. Vyzkoušíš a vidíš.
Umělá inteligence dnes umí napsat aplikaci za vás — stačí jí říct, co chcete, a ona to postaví. V téhle epizodě rozebíráme fenomén Vibe Codingu od základů: jak vznikl, co za ním stojí a které nástroje jako Cursor, Bolt, Lovable nebo Replit teď frčí nejvíc. Projdeme reálné use casy, kde Vibe Coding skutečně září, ale také místa, kde naráží na své limity — technický dluh, škálovatelnost a práce s citlivými daty. Podíváme se na rozdíl mezi Vibe Codingem a AI-asistovaným programováním, probereme PRD techniku pro lepší výsledky a zamyslíme se nad tím, co tahle revoluce znamená pro budoucnost vývoje softwaru a pro každého z nás.
53minVíce →